Ao lançar uma moeda uma vez, qual é a probabilidade de obter "cara"?
Resposta fácil! Se a moeda for honesta, a probabilidade é de 50%. Em outras palavras, se você apostar em cara e der cara, você vence; caso contrário, você perde. Sucesso ou fracasso, ocorrência ou não ocorrência, concretizar uma venda ou não — todos esses resultados podem ser representados pelos valores 0 e 1.
O lançamento de uma moeda é apenas um exemplo de experimento no qual não se pode controlar as probabilidades dos resultados. No entanto, no mundo real, muitos eventos não ocorrem de forma aleatória ou sem controle sobre os desfechos; trata-se, para nós, de identificar corretamente as variáveis que influenciam essas probabilidades. Por exemplo, o volume de vendas pode ser aumentado ajustando-se o preço do produto, melhorando a qualidade e os investimentos em publicidade, entre outras ações. Da mesma forma, a rotatividade de funcionários pode ser gerenciada mediante a identificação de incentivos chave de retenção e a mitigação dos fatores que impulsionam o turnover. E assim por diante.
Neste artigo, abordarei uma técnica utilizada para identificar e estimar essas probabilidades: o modelo logístico. Com esse modelo, é possível identificar as variáveis que mais impactam os resultados.
Mas antes, exploraremos alguns conceitos que introduzem e aprofundam o entendimento dessa técnica.
1. Conceitos e fundamentos chaves
Ter sucesso ou não ter sucesso é um resultado binário que segue o que se chama de distribuição de Bernoulli, com probabilidade p de ocorrer e probabilidade 1-p de não ocorrer, sendo que a soma de p e 1-p é 1 (100%).
|
Evento |
Y |
Probabilidade |
|
Ocorrer |
1 |
Pi |
|
Não ocorrer |
0 |
(1 – Pi) |
|
Total |
100% |
A distribuição de Bernoulli é um caso particular da distribuição binomial em que se realiza uma única tentativa (ou seja, n é igual a 1 para uma distribuição binomial) e, por vezes, é expressa da seguinte forma:
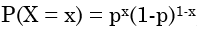 , então:
- Se x=0 =>
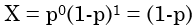
- Se x=1 =>
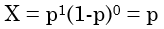
A resposta é uma variável binária, mas muitos cientistas de dados utilizam a regressão linear para estimar essas probabilidades (0 e 1). Essa é uma boa prática? Obviamente que não.
Considere a seguinte equação linear:
Ŷi = β1 + β2Xi + ui, considerando E(ui) = 0
Se Ŷi se for uma resposta binária (0 ou 1), a regressão ajustada deve ser:
Ŷi = β1 + β2Xi <=> 0 ≤ Ŷi ≤ 1 ou;
P̂i = β1 + β2Xi <=> 0 ≤ P̂i ≤ 1
A equação acima representa o modelo de probabilidade linear (MPL) e corresponde a uma linha reta. Nesse caso, não se pode garantir que os resultados (P̂i ou Ŷi) respeitarão os limites [0, 1]. Dependendo do valor de Xi, Ŷi pode ser negativo ou superior a 1, a menos que sejam aplicadas as seguintes restrições:
1 – se Ŷi for negativo, considera-se 0 como previsão;
2 – se Ŷi for superior a 1, considera-se 1 como previsão.
Abaixo, apresentam-se as figuras que ilustram o MPL sem restrições (a) e com restrições (b):
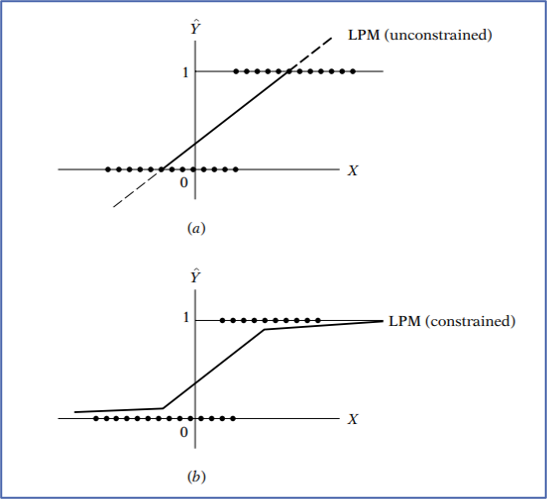
Figura 1: Linear probability models. Fonte: Basic Econometrics 4th ed. Gujarati
Uma maneira melhor de garantir adequadamente que as probabilidades condicionais estimadas E(Yi) estejam entre 0 e 1 é utilizar modelos probit ou logit. Ambos apresentam resultados semelhantes, mas, neste artigo, mostrarei como extrair informações úteis do modelo logit (ou modelo de regressão logística).
Diferentemente do modelo linear, no qual a probabilidade é uma transformação linear da variável Xi (Pi = β1 + β2Xi), em um modelo de regressão logística as probabilidades de ocorrência e não ocorrência são dadas por:
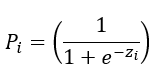
e
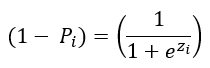
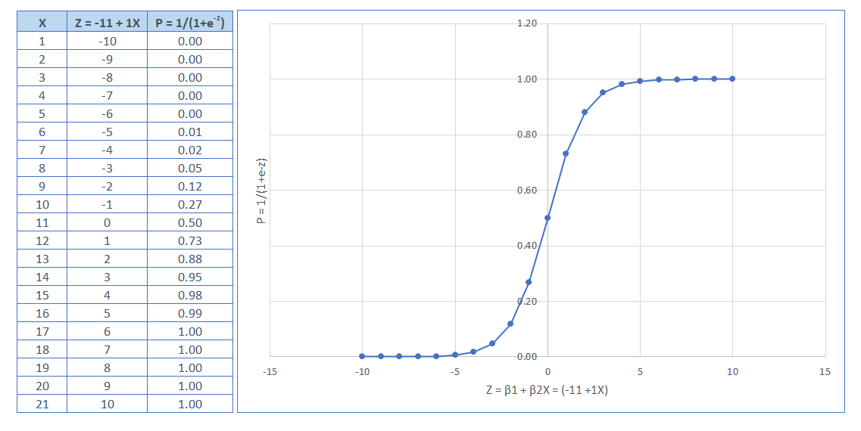
Onde o termo zi = β1 + β2Xi é chamado logit.
Observe na figura abaixo que o logit é uma transformação linear de X e que a função de probabilidade assume a forma de uma curva sigmoide, variando de -∞ a +∞, com limites no intervalo [0, 1].
Uma métrica interessante é chamada de razão das
chances (odds ratio):  . Ela representa o quanto a probabilidade de
ocorrência é maior (ou menor) do que a de não ocorrência. Assim, por exemplo,
se a probabilidade de ocorrência de uma venda for 0,8, a de não ocorrência será
0,2. Nesse caso, a razão das chances (odds ratio) é igual a 4, indicando
que a probabilidade de ocorrência é quatro vezes maior do que a de não
ocorrência. Uma chance de 50/50 (como no lançamento de uma moeda) resulta em
uma razão igual a 1. Portanto, se a ocorrência for um evento positivo (como uma
venda), a melhor estratégia é manter essa razão acima de 1 — ou seja, com a
probabilidade de venda superior à probabilidade de não venda.
Conceitualmente, o logit é calculado a partir dessa métrica como o logaritmo da razão das chances (a probabilidade de ocorrência dividida pela probabilidade de não ocorrência).
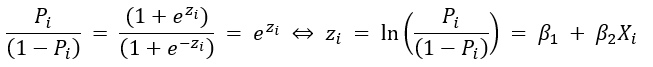
Adicionalmente se:
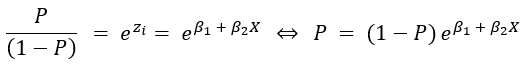
Então:
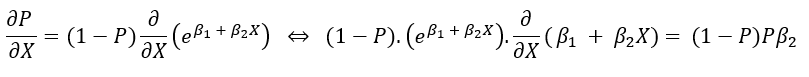
2. Por que tudo isso é importante? Interpretando o modelo
A análise é bastante simples. Se o logit representa o logaritmo da razão de chances (odds ratio), podemos determinar o impacto da variável X na ocorrência de um evento simplesmente calculando a exponencial dos coeficientes (lembre-se: a exponencial também é chamada de antilogaritmo).
Para facilitar a visualização, considere um exemplo hipotético. Suponha que você possua um grande banco de dados com consultas históricas de clientes, contendo registros em que o cliente confirmou o pedido de compra (1) e outros em que não o fez (0). Nessa situação, metade dos clientes adquiriu seus produtos e a outra metade não; portanto, sua razão de chances atual é 1 (50% / 50%).
Você sabe que não atua em um mercado de produtos homogêneos (ou seja, aquele em que os clientes não percebem diferenças entre os seus produtos e os da concorrência). Assim, além do preço, é preciso identificar no banco de dados as variáveis relevantes que levam os clientes a efetivar os pedidos. Visto que seus produtos apresentam certo grau de diferenciação, variáveis como durabilidade, garantia, preço, capacidade e velocidade (supondo que se trate de um notebook), bem como outras características percebidas pelos clientes, devem ser incluídas no modelo. Você realizou esse procedimento e, após executar uma regressão logística, obteve a seguinte equação:
Vendas (sim ou não) = -25.93 + 0.3(garantia) + 0.5(durabilidade) - 0.10(preço)
Para simplificar este exemplo, vamos supor que as outras variáveis não sejam estatisticamente significativas, apenas estas 3. A garantia é medida em meses, a durabilidade em anos e o preço em milhares de dólares.
Pergunta: O que os coeficientes indicam sobre a probabilidade de vendas?
Garantia: o coeficiente é 0,3, portanto, mantendo todos
os outros preditores constantes, a probabilidade de um cliente confirmar o
pedido aumenta em 0,3*(0,5*0,5) = 7,5% para cada mês adicionado à garantia. A
probabilidade anterior aumentará de 50% para 57,5%, e a razão de chances
aumentará 35% (0,575/0,425 = 1,35). Esse aumento na razão de chances é
confirmado pela exponenciação do coeficiente 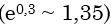 .
Durabilidade: o coeficiente é 0,5, portanto, mantendo todos
os outros preditores constantes, a probabilidade de um cliente confirmar o
pedido aumenta em 0,5*(0,5*0,5) = 12,5% para cada ano adicionado à
durabilidade. A probabilidade anterior aumentará de 50% para 62,5%, e a razão
de chances aumentará em 66% (0,625/0,375 = 1,66). Esse aumento na razão de
chances é confirmado pela exponenciação do coeficiente 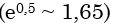 .
Preço: neste caso, o coeficiente é negativo (-0,10),
portanto, mantendo todos os outros preditores constantes, a probabilidade de um
cliente confirmar o pedido diminui em -0,1*(0,5*0,5) = -2,5% para cada mil
dólares adicionados ao preço do produto. A probabilidade anterior diminuirá de
50% para 47,5%, e a razão de chances diminuirá 10% (0,475/0,525 = 0,90). Essa
diminuição na razão de chances é confirmada pela exponenciação do coeficiente
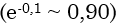 .
Observe que esta é uma análise fria com números hipotéticos, apenas para contextualizar quão poderosa é a regressão logística. Em nosso exemplo, a melhoria na qualidade pode causar um aumento de preço e os resultados nas vendas seriam um percentual líquido considerando os aumentos na durabilidade e no preço. Outro ponto: a melhoria na durabilidade também pode comprometer sua própria demanda (os produtos duram mais), então, em vez de um bom resultado, você pode ter o oposto (uma diminuição no número de pedidos feitos por seus clientes).
3. Outros exemplos de aplicação do modelo (exemplo incluído)
Existem muitos outros exemplos de aplicação dessa técnica; aqui estão alguns:
- Análise de risco de crédito, com base na renda do cliente, inadimplência passada, valor atual da dívida etc.
- Rotatividade de funcionários, com base na satisfação no trabalho, renda mensal, horas extras, distância de casa etc.
- Avaliação de produtos, como, por exemplo, a qualidade do vinho com base em características físico-químicas (Wine Quality - UCI Machine Learning Repository). Nesse caso, a variável de resposta varia de 1 a 10, portanto, não é binomial. Se você precisar prever as probabilidades de diferentes resultados possíveis (ou seja, mais de 2 resultados) com base em variáveis independentes, deve considerar uma regressão logística multinominal.
Mesmo assim, vamos utilizar o banco de dados de qualidade do vinho para simular um exemplo do impacto de características nas vendas do produto.
Exemplo com o conjunto de dados de qualidade do vinho do repositório da UCI.
O banco de dados de qualidade de vinhos será utilizado como exemplo. Ele está disponível publicamente no repositório UCI ML e pode ser facilmente acessado utilizando a biblioteca ucimlrepo em Python. O banco de dados contém 6.497 registros (vinhos distintos) com 11 características (variáveis) distintas: acidez fixa, acidez volátil, ácido cítrico, açúcar residual, cloretos, dióxido de enxofre livre, dióxido de enxofre total, densidade, pH, sulfatos e teor alcoólico. A variável alvo é a qualidade do vinho, avaliada por especialistas em uma escala de 0 a 10. Um ponto importante sobre este conjunto de dados é que, devido a questões de privacidade e logística, estão disponíveis apenas variáveis físico-químicas (entradas) e sensoriais (a saída); ou seja, não há dados sobre tipos de uva, marca do vinho, preço de venda etc.
Abaixo, apresenta-se a distribuição de cada variável (características e alvo):
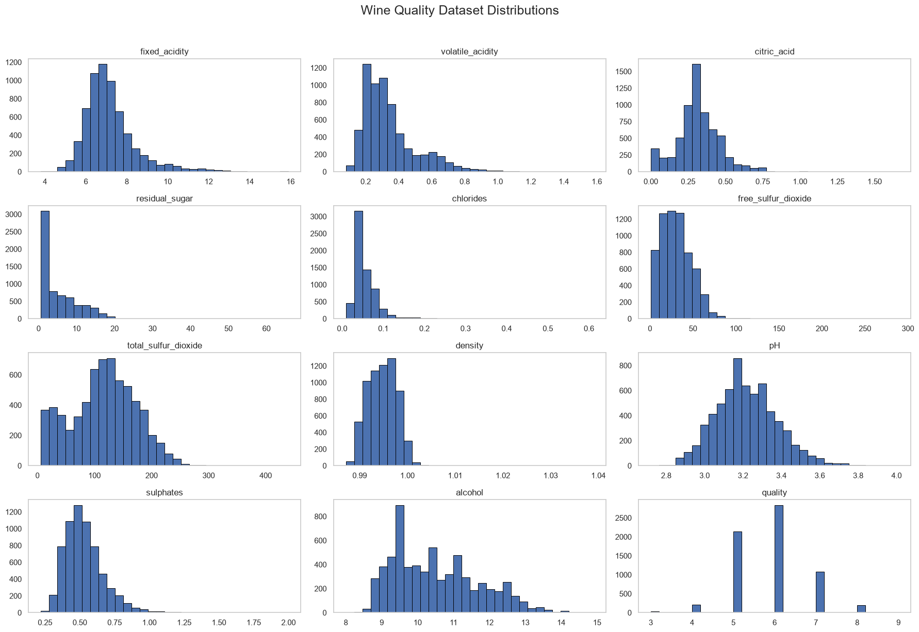
Para criar uma simulação, transformaremos a qualidade em uma variável binária. Pode-se imaginar que, dependendo da pontuação, o vinho possa ser classificado como de "bom ou mau paladar", "aprovado ou não aprovado" ou "vendido ou não vendido". Em nosso caso, consideraremos os resultados de qualidade de 0 a 5 como "Não Venda" e de 6 a 10 como "Venda".
Resultados
Após a detecção e exclusão dos outliers (usado distância de Mahalanobis), foram selecionados 6.334 dos 6.497 registros iniciais (vinhos) – 2.297 classificados como "0" e 4.037 classificados como "1". Isso significa:
P = 0,637 (63,7%)
(1-P) = 0,363 (36,3%) e,
Razão das chances (odds ratio) = 1,758.
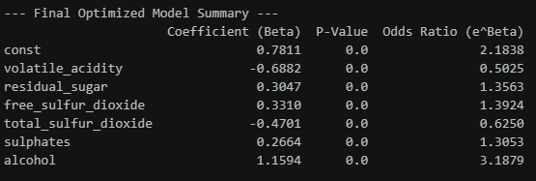
O banco de dados foi dividido em conjuntos de "treino" (5.067 registros) e "teste" (1.267 registros). Ambos os subconjuntos apresentam uma razão de chances semelhante à do conjunto de dados original. Após a execução do modelo no subconjunto de "treino", 5 variáveis não se mostraram estatisticamente significativas: cloretos, densidade, acidez fixa, pH e ácido cítrico. Os resultados das variáveis restantes estão apresentados abaixo:
Acurácia do modelo
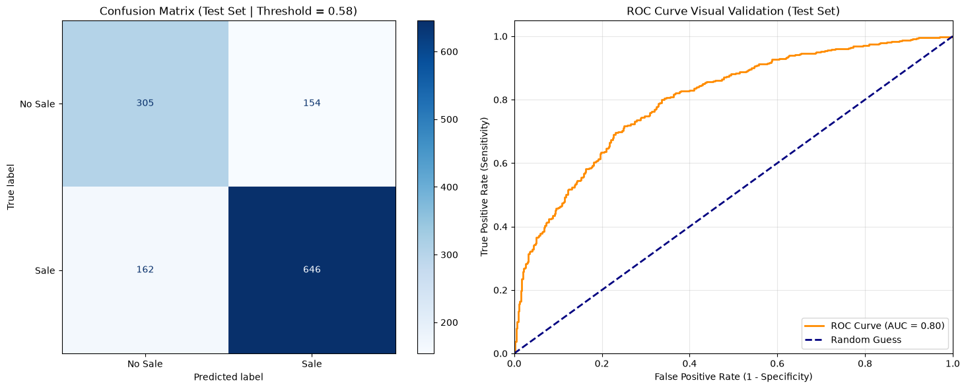
Ao comparar os valores reais do conjunto de dados de teste com as saídas estimadas (y_hat) utilizando um limiar de 0,58, o modelo alcançou 75% de acurácia, com 80% de Verdadeiros Positivos e 34% de Falsos Positivos. Abaixo, apresentam-se a matriz de confusão e a curva ROC.
Análise
Vamos analisar dois coeficientes da regressão.
O que a nova razão de chances (odds ratio) da acidez volátil indica? Ela apresenta um valor negativo de -0,6882, indicando um impacto negativo em P (Venda). Isso significa que, se adicionarmos uma unidade de acidez volátil ao vinho, a razão de chances cairá 50,25%: do valor inicial de 1,758 para cerca de 0,883. P diminuirá de 63,7% para cerca de 46,9% e, consequentemente, (1-P) aumentará de 36,3% para 53,1%.
Por outro lado, o teor alcoólico é a variável que exerce o impacto mais positivo na qualidade. A nova razão de chances aumentará cerca de 219%: do valor inicial de 1,758 para aproximadamente 5,603 (1,758 * 3,1879). Assim, P aumentará de 63,7% para cerca de 84,9%, e (1-P) diminuirá de 36,3% para 15,1%.
É notório que os especialistas consideram a composição alcoólica uma característica muito positiva, enquanto a acidez volátil é vista como uma característica muito negativa.
Conclusão
A regressão logística é uma ferramenta poderosa e de simples leitura, podendo ser utilizada em várias áreas, como por exemplo em finanças, RH ou supply chain. Geralmente lançamentos de novos produtos se baseiam no simples aperfeiçoamento de produtos antigos (e.g., um novo produto que oferece melhor performance). Nesses casos, a metodologia comprova-se ser uma ferramenta poderosa na estratégia de vendas das empresas.